Sitemap sudah dibuat dan sudah dikirim melalui Google Search Console, tetapi artikel baru di website masih belum juga di-crawl Google?
Situasi seperti ini cukup sering membuat pemilik website bingung. Apalagi ketika di Google Search Console sitemap sudah menunjukkan status Success, sementara URL artikel yang baru diterbitkan belum terlihat aktivitas crawling-nya.
Hal penting yang perlu dipahami sejak awal adalah status sitemap dan status URL merupakan dua hal yang berbeda.
Google memang akan mencoba mengambil sitemap setelah sitemap dikirim. Jika sitemap berhasil dibaca, URL yang ditemukan di dalamnya dapat masuk ke antrean crawling. Namun hal tersebut tidak berarti setiap URL langsung dikunjungi Googlebot atau otomatis masuk Google Index.
Jadi, kalau sitemap sudah dikirim tetapi artikel belum di-crawl, jangan langsung menganggap sitemap mengalami masalah.
Ada beberapa hal yang perlu diperiksa.
Apa Itu Sitemap?
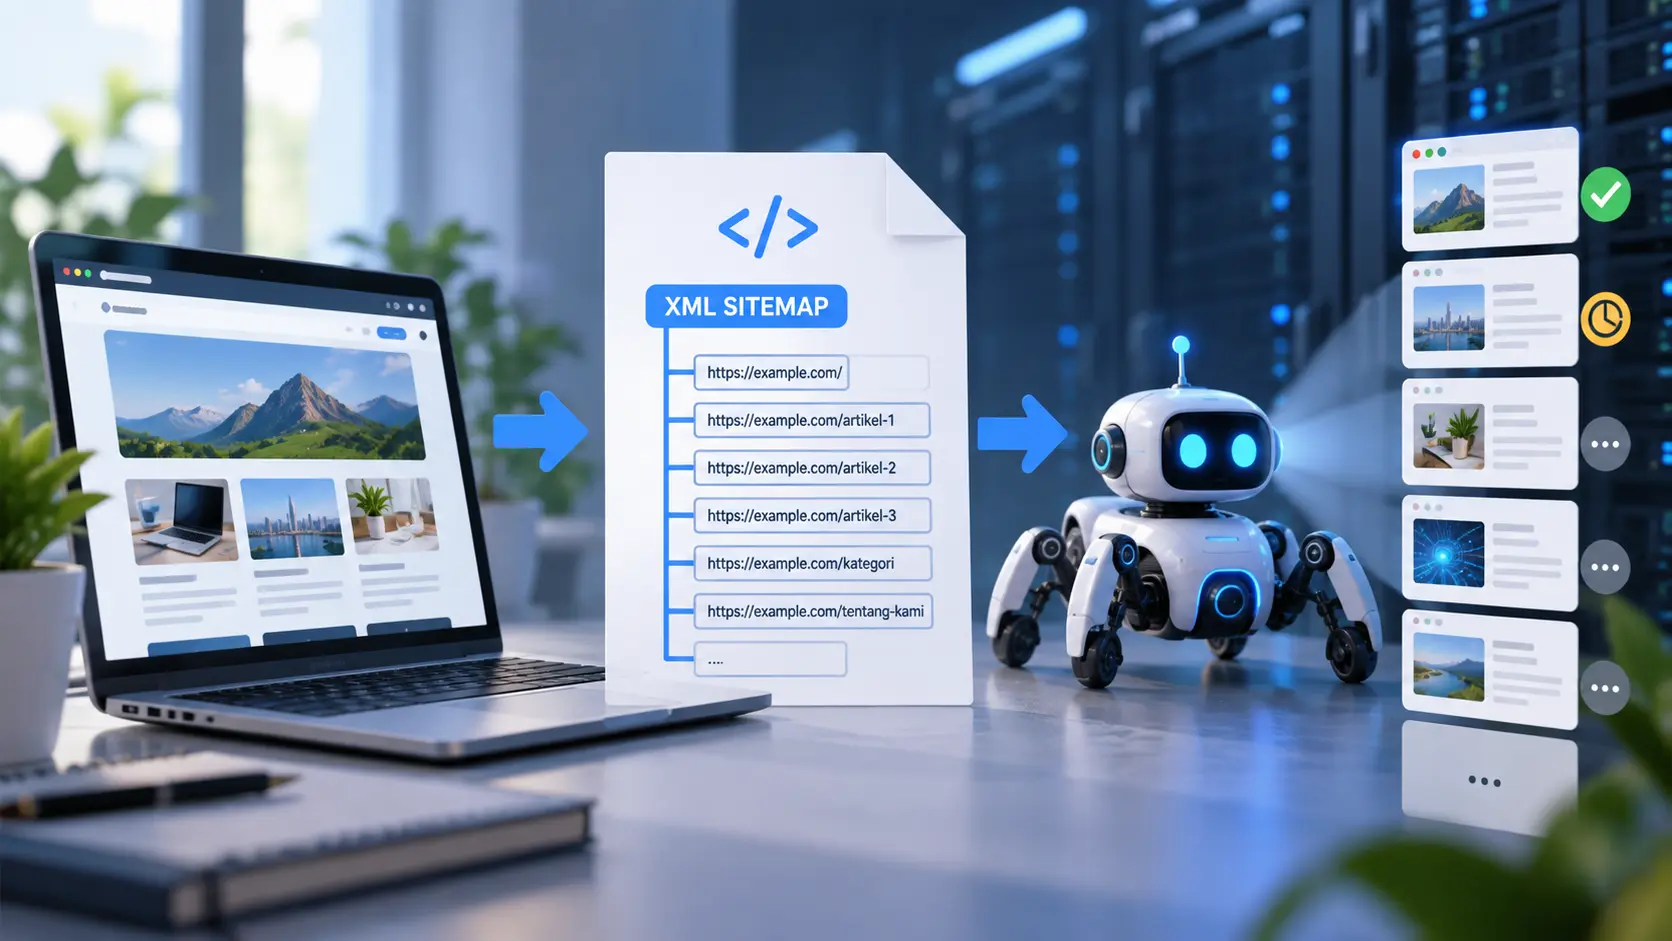
Sitemap adalah file terstruktur yang berisi daftar URL penting dari sebuah website.
Format yang paling umum digunakan adalah XML Sitemap.
Contoh sederhananya:
<?xml version="1.0" encoding="UTF-8"?>

<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">

    <url>
        <loc>https://example.com/</loc>
    </url>

    <url>
        <loc>https://example.com/artikel/contoh-artikel</loc>
    </url>

    <url>
        <loc>https://example.com/artikel/artikel-kedua</loc>
    </url>

</urlset>
Tujuan utama sitemap adalah membantu mesin pencari menemukan halaman yang ada di website.
Namun sitemap bukanlah perintah yang mengatakan:
Google, crawl semua URL ini sekarang juga.
Sitemap lebih tepat dianggap sebagai daftar URL yang ingin kita informasikan kepada mesin pencari.
Bayangkan kita memberikan daftar alamat kepada seorang kurir. Daftar tersebut membantu kurir mengetahui alamat mana saja yang tersedia. Namun waktu kunjungan ke masing-masing alamat tetap ditentukan oleh sistem pengiriman.
Hal yang kurang lebih sama terjadi pada proses crawling Google.
Sitemap Sudah Success, Apakah Berarti Semua URL Sudah Di-Crawl?
Tidak.
Ini adalah salah satu kesalahpahaman yang paling umum.
Ketika sitemap di Google Search Console menunjukkan status Success, artinya Google berhasil mengambil dan memproses sitemap tersebut tanpa error.
Ketika sitemap berhasil diproses, URL yang ditemukan dapat masuk ke antrean crawling. Namun hal tersebut bukan berarti seluruh URL langsung dikunjungi Googlebot.
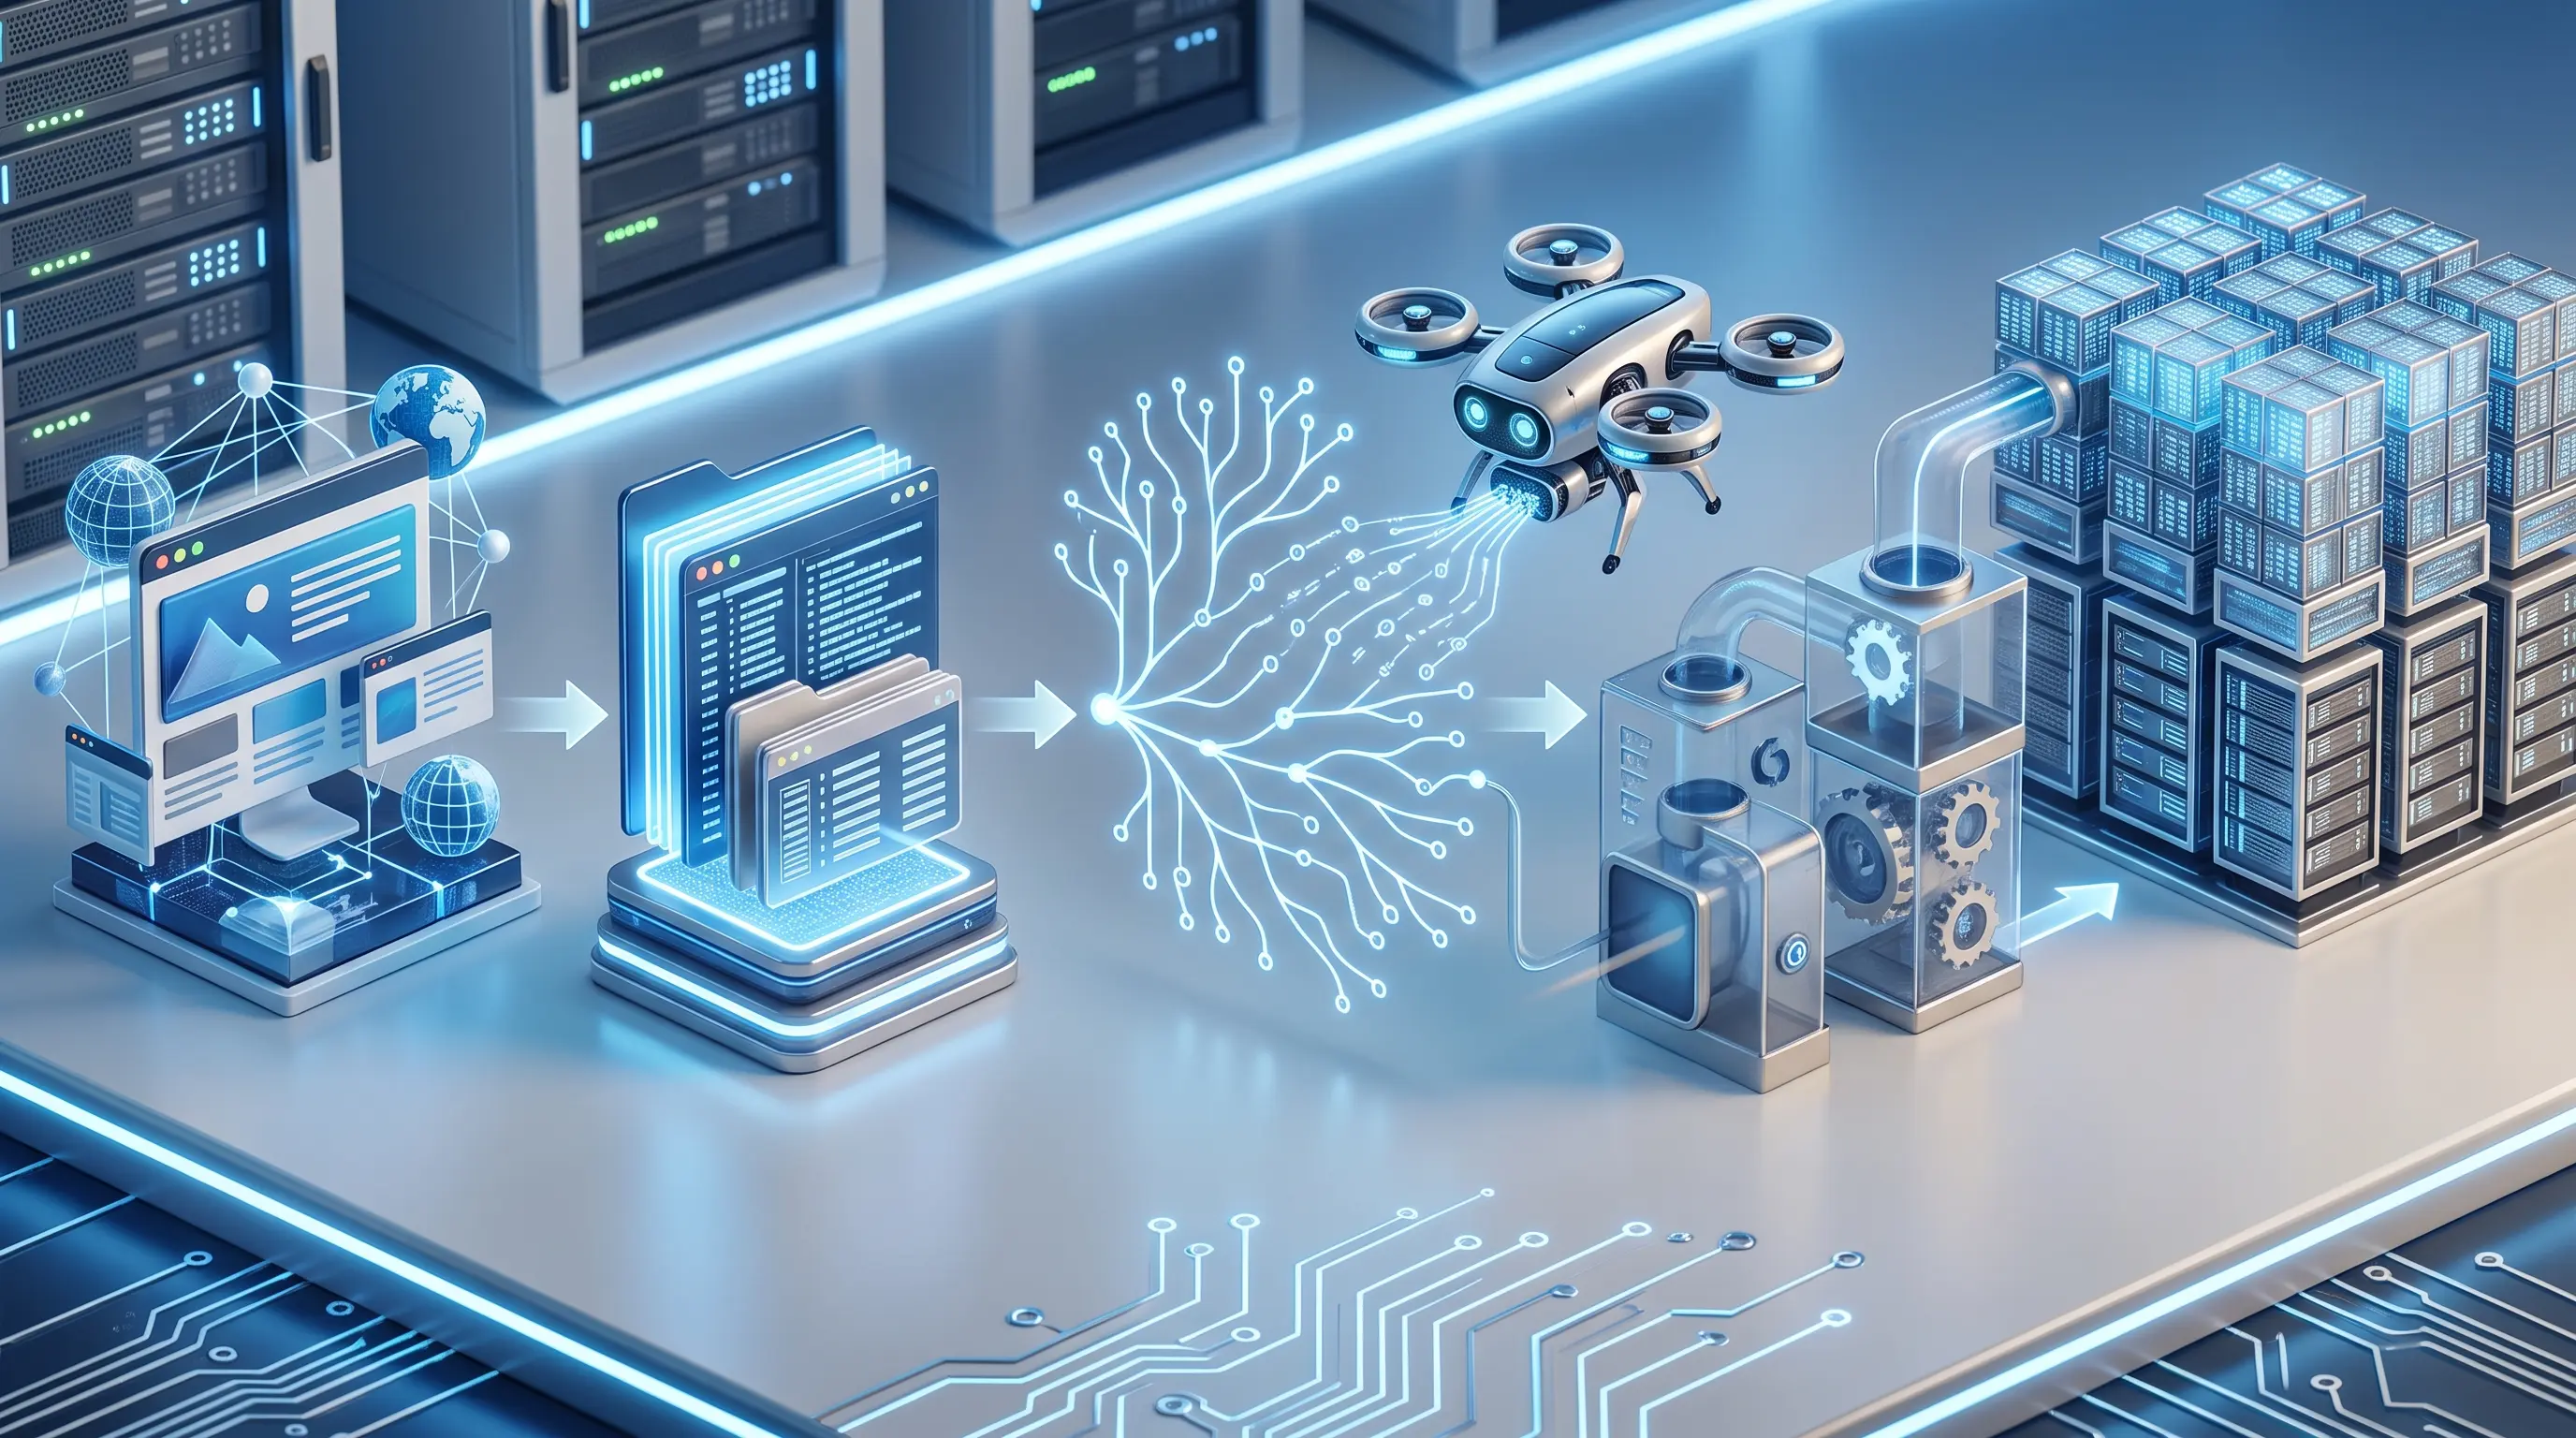
Alurnya kurang lebih seperti ini:
- Sitemap dibuat.
- Sitemap dikirim ke Google Search Console.
- Google mengambil sitemap.
- Sitemap berhasil diproses.
- URL ditemukan.
- URL masuk antrean crawling.
- Googlebot mengunjungi URL.
- Halaman diproses.
- Google menentukan status indexing.
Jadi:
Sitemap Success ≠ semua URL sudah di-crawl
Dan:
Sudah di-crawl ≠ otomatis sudah di-index
Karena itu, proses crawling dan indexing sebaiknya dipahami sebagai tahapan yang berbeda.
Kenapa Sitemap Sudah Dikirim Tapi Google Belum Crawl?
Ada beberapa kemungkinan yang perlu diperiksa.
1. URL Masih Menunggu Antrean Crawling
Setelah Google berhasil membaca sitemap, URL yang ditemukan tidak selalu langsung dikunjungi satu per satu.
Google memasukkan URL ke proses crawling sesuai sistem dan prioritasnya.
Jadi kalau artikel baru saja dimasukkan ke sitemap, sangat mungkin URL tersebut masih menunggu proses crawling.
Ini terutama bisa terjadi pada website yang masih berkembang atau baru menerbitkan banyak URL.
Google menjelaskan bahwa setelah URL diketahui, proses crawling dan indexing dapat membutuhkan waktu.
Jadi kalau artikel baru diterbitkan beberapa jam lalu dan belum terlihat Googlebot mengunjunginya, belum tentu ada masalah.
Yang perlu dilakukan:
- Pastikan URL bisa dibuka.
- Pastikan URL masuk sitemap.
- Pastikan robots.txt tidak memblokirnya.
- Pastikan artikel memiliki internal link.
- Berikan waktu bagi Google untuk memprosesnya.
2. Website Masih Relatif Baru
Website baru biasanya belum memiliki banyak halaman yang sudah diketahui Google.
Misalnya website baru memiliki 20 artikel. Sitemap sudah dibuat dan seluruh artikel dimasukkan ke dalamnya. Tetapi Google masih dalam tahap mengenali struktur website tersebut.
Dalam kondisi seperti ini, jangan berharap semua artikel langsung mendapatkan perlakuan yang sama dengan website yang sudah memiliki ribuan halaman dan riwayat crawling yang panjang.
Ini bukan berarti website baru tidak bisa mendapatkan traffic dari Google. Hanya saja proses discovery, crawling, dan indexing dapat membutuhkan waktu.
3. Artikel Hanya Ditemukan Melalui Sitemap
Sitemap memang membantu Google menemukan URL, tetapi jangan hanya mengandalkan sitemap.
Misalnya kita membuat artikel:
https://example.com/artikel/cara-mengecek-ip-addressURL tersebut sudah masuk sitemap. Namun tidak ada satu pun halaman lain yang memberikan link menuju artikel tersebut.
Google memang tetap dapat menemukan URL melalui sitemap, tetapi struktur internal website tidak memberikan jalur tambahan untuk menemukan halaman tersebut.
Karena itu, artikel baru sebaiknya juga mendapatkan internal link.
Contohnya:
Homepage
   ↓
Kategori
   ↓
Artikel A
   ↓
Artikel B
   ↓
Artikel C
Artikel baru juga bisa ditautkan dari:
- Halaman kategori.
- Artikel terkait.
- Halaman artikel terbaru.
- Homepage.
- Artikel lama yang relevan.
Dengan begitu, Google memiliki lebih dari satu jalur untuk menemukan halaman.
4. Robots.txt Memblokir URL
Ini salah satu bagian yang wajib diperiksa ketika URL tidak kunjung di-crawl.
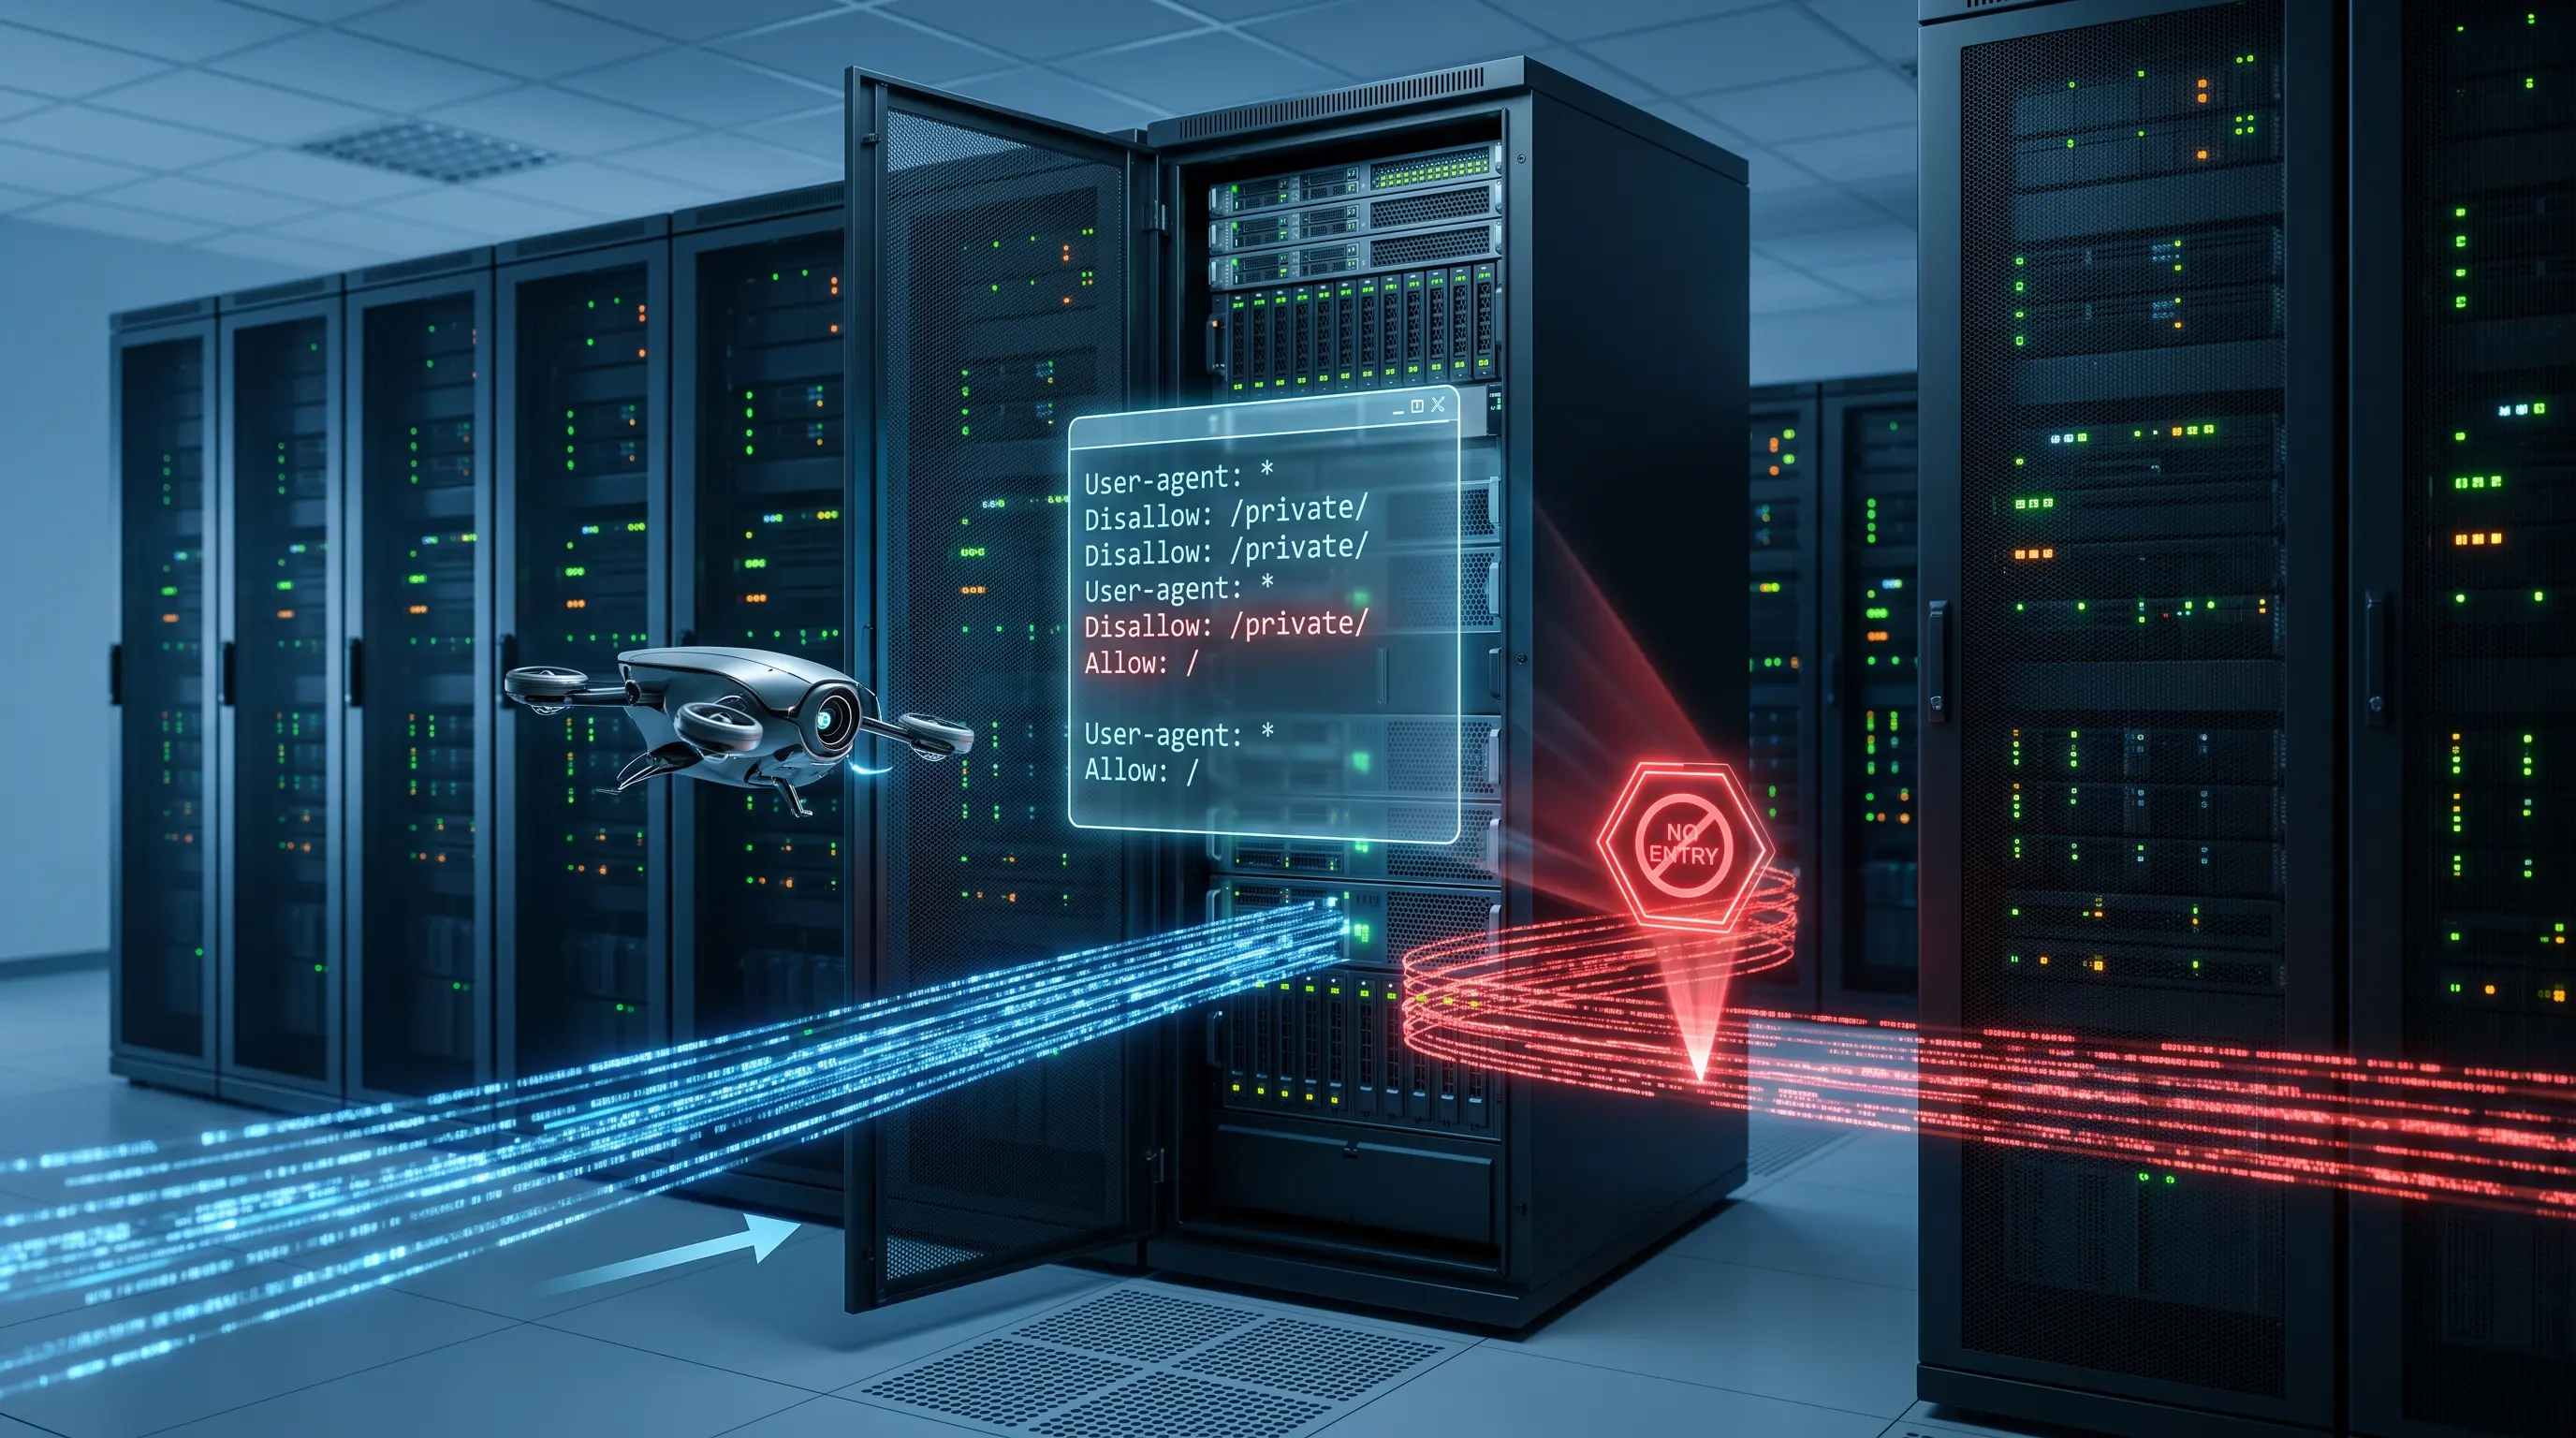
File robots.txt digunakan untuk memberikan aturan kepada crawler mengenai bagian website yang boleh atau tidak boleh diakses.
Contoh:
User-agent: *
Disallow: /artikel/
Jika artikel berada di:
https://example.com/artikel/contoh
aturan tersebut dapat menghalangi Googlebot mengakses path /artikel/.
Karena itu, buka:
https://domainkamu.com/robots.txtKemudian periksa apakah terdapat aturan yang tidak sengaja memblokir halaman penting.
Contoh konfigurasi sederhana:
User-agent: *
Allow: /

Sitemap: https://example.com/sitemap.xml
Konfigurasi sebenarnya bisa berbeda tergantung kebutuhan website. Jangan sekadar menyalin konfigurasi dari website lain tanpa memahami aturan yang digunakan.
5. URL di Sitemap Tidak Bisa Diakses
Sitemap bisa saja terlihat normal, tetapi URL di dalamnya bermasalah.
Misalnya sitemap berisi:
https://example.com/artikel/contohKetika URL tersebut dibuka, ternyata server memberikan:
404 Not Foundatau:
500 Internal Server Erroratau bahkan melakukan redirect berantai.
Dalam kondisi seperti itu, URL tersebut membutuhkan pemeriksaan lebih lanjut.
Pastikan URL di sitemap:
- Benar.
- Menggunakan HTTPS yang sesuai.
- Menggunakan domain yang benar.
- Dapat diakses.
- Tidak mengarah ke halaman yang sudah dihapus.
- Merupakan URL yang memang ingin diproses Google.
6. Sitemap Tidak Berisi URL Artikel Terbaru
Ini terdengar sederhana, tetapi cukup sering terjadi pada website dengan sitemap custom.
Misalnya kita baru menerbitkan:
/artikel/sitemap-sudah-dikirimKemudian kita membuka:
/sitemap.xmlTernyata URL tersebut tidak ada.
Kalau begitu, Google memang belum mendapatkan URL tersebut melalui sitemap.
Masalah seperti ini bisa terjadi jika:
- Generator sitemap tidak otomatis diperbarui.
- Query database sitemap bermasalah.
- Cache sitemap masih menggunakan data lama.
- Artikel baru belum memenuhi kondisi query.
- Sitemap hanya mengambil jumlah artikel tertentu.
Untuk website custom, bagian generator sitemap perlu diperiksa.
Pastikan setelah artikel baru diterbitkan, URL tersebut benar-benar muncul di XML sitemap.
7. Server Mengalami Error atau Sulit Diakses
Masalah crawling juga bisa berasal dari server.
Contohnya:
500 Internal Server Error
502 Bad Gateway
503 Service Unavailable
504 Gateway Timeout
Jika Googlebot mencoba mengakses halaman tetapi server gagal memberikan respons yang normal, proses crawling dapat terganggu.
Karena itu, access log server sangat berguna untuk melakukan troubleshooting.
8. Halaman Menggunakan noindex
Selain robots.txt, periksa juga apakah halaman menggunakan noindex.
Contohnya:
<meta name="robots" content="noindex">Instruksi tersebut memberitahu mesin pencari agar halaman tidak dimasukkan ke index.
Namun perlu dibedakan antara crawling dan indexing.
robots.txt berhubungan dengan akses crawler, sedangkan noindex berhubungan dengan keputusan indexing.
9. Canonical Mengarah ke URL Lain
Canonical juga perlu diperiksa ketika artikel sudah di-crawl tetapi tidak masuk index seperti yang diharapkan.
Misalnya artikel:
https://example.com/artikel-amemiliki:
<link rel="canonical" href="https://example.com/artikel-b">Artinya halaman tersebut memberi sinyal bahwa URL lain dianggap sebagai versi canonical.
Google dapat memilih canonical berdasarkan berbagai sinyal.
10. Jangan Panik Kalau Baru Beberapa Jam
Ini mungkin bagian paling penting untuk website yang rutin menerbitkan artikel.
Misalnya:
- 07.00 — artikel diterbitkan.
- 07.05 — sitemap diperbarui.
- 07.10 — sitemap sudah tersedia untuk Google.
- 08.00 — artikel belum di-crawl.
Dalam kondisi seperti ini, belum ada alasan untuk langsung menyimpulkan bahwa website mengalami masalah.
Crawling dan indexing membutuhkan proses. Untuk halaman baru, Google tidak memberikan jaminan bahwa URL akan langsung di-crawl setelah sitemap diperbarui.
Cara Mengecek Sitemap di Google Search Console
Untuk memeriksa sitemap, buka Google Search Console kemudian masuk ke laporan Sitemaps.
Biasanya informasi yang dapat dilihat mencakup:
- URL sitemap.
- Tanggal pengiriman.
- Waktu terakhir sitemap dibaca.
- Status sitemap.
- Jumlah URL yang ditemukan.
Jika Statusnya Success
Artinya sitemap berhasil dimuat dan diproses.
Tetapi jangan mengartikannya sebagai semua URL sudah di-crawl.
Jika Statusnya Has Errors
Buka detail sitemap dan lihat error yang dilaporkan.
Jika Sitemap Gagal Diambil
Jika Google tidak dapat mengambil sitemap, periksa URL sitemap, HTTPS, DNS, response server, robots.txt, redirect, dan akses publik terhadap sitemap.
Cara Mengecek Apakah URL Sudah Diketahui Google
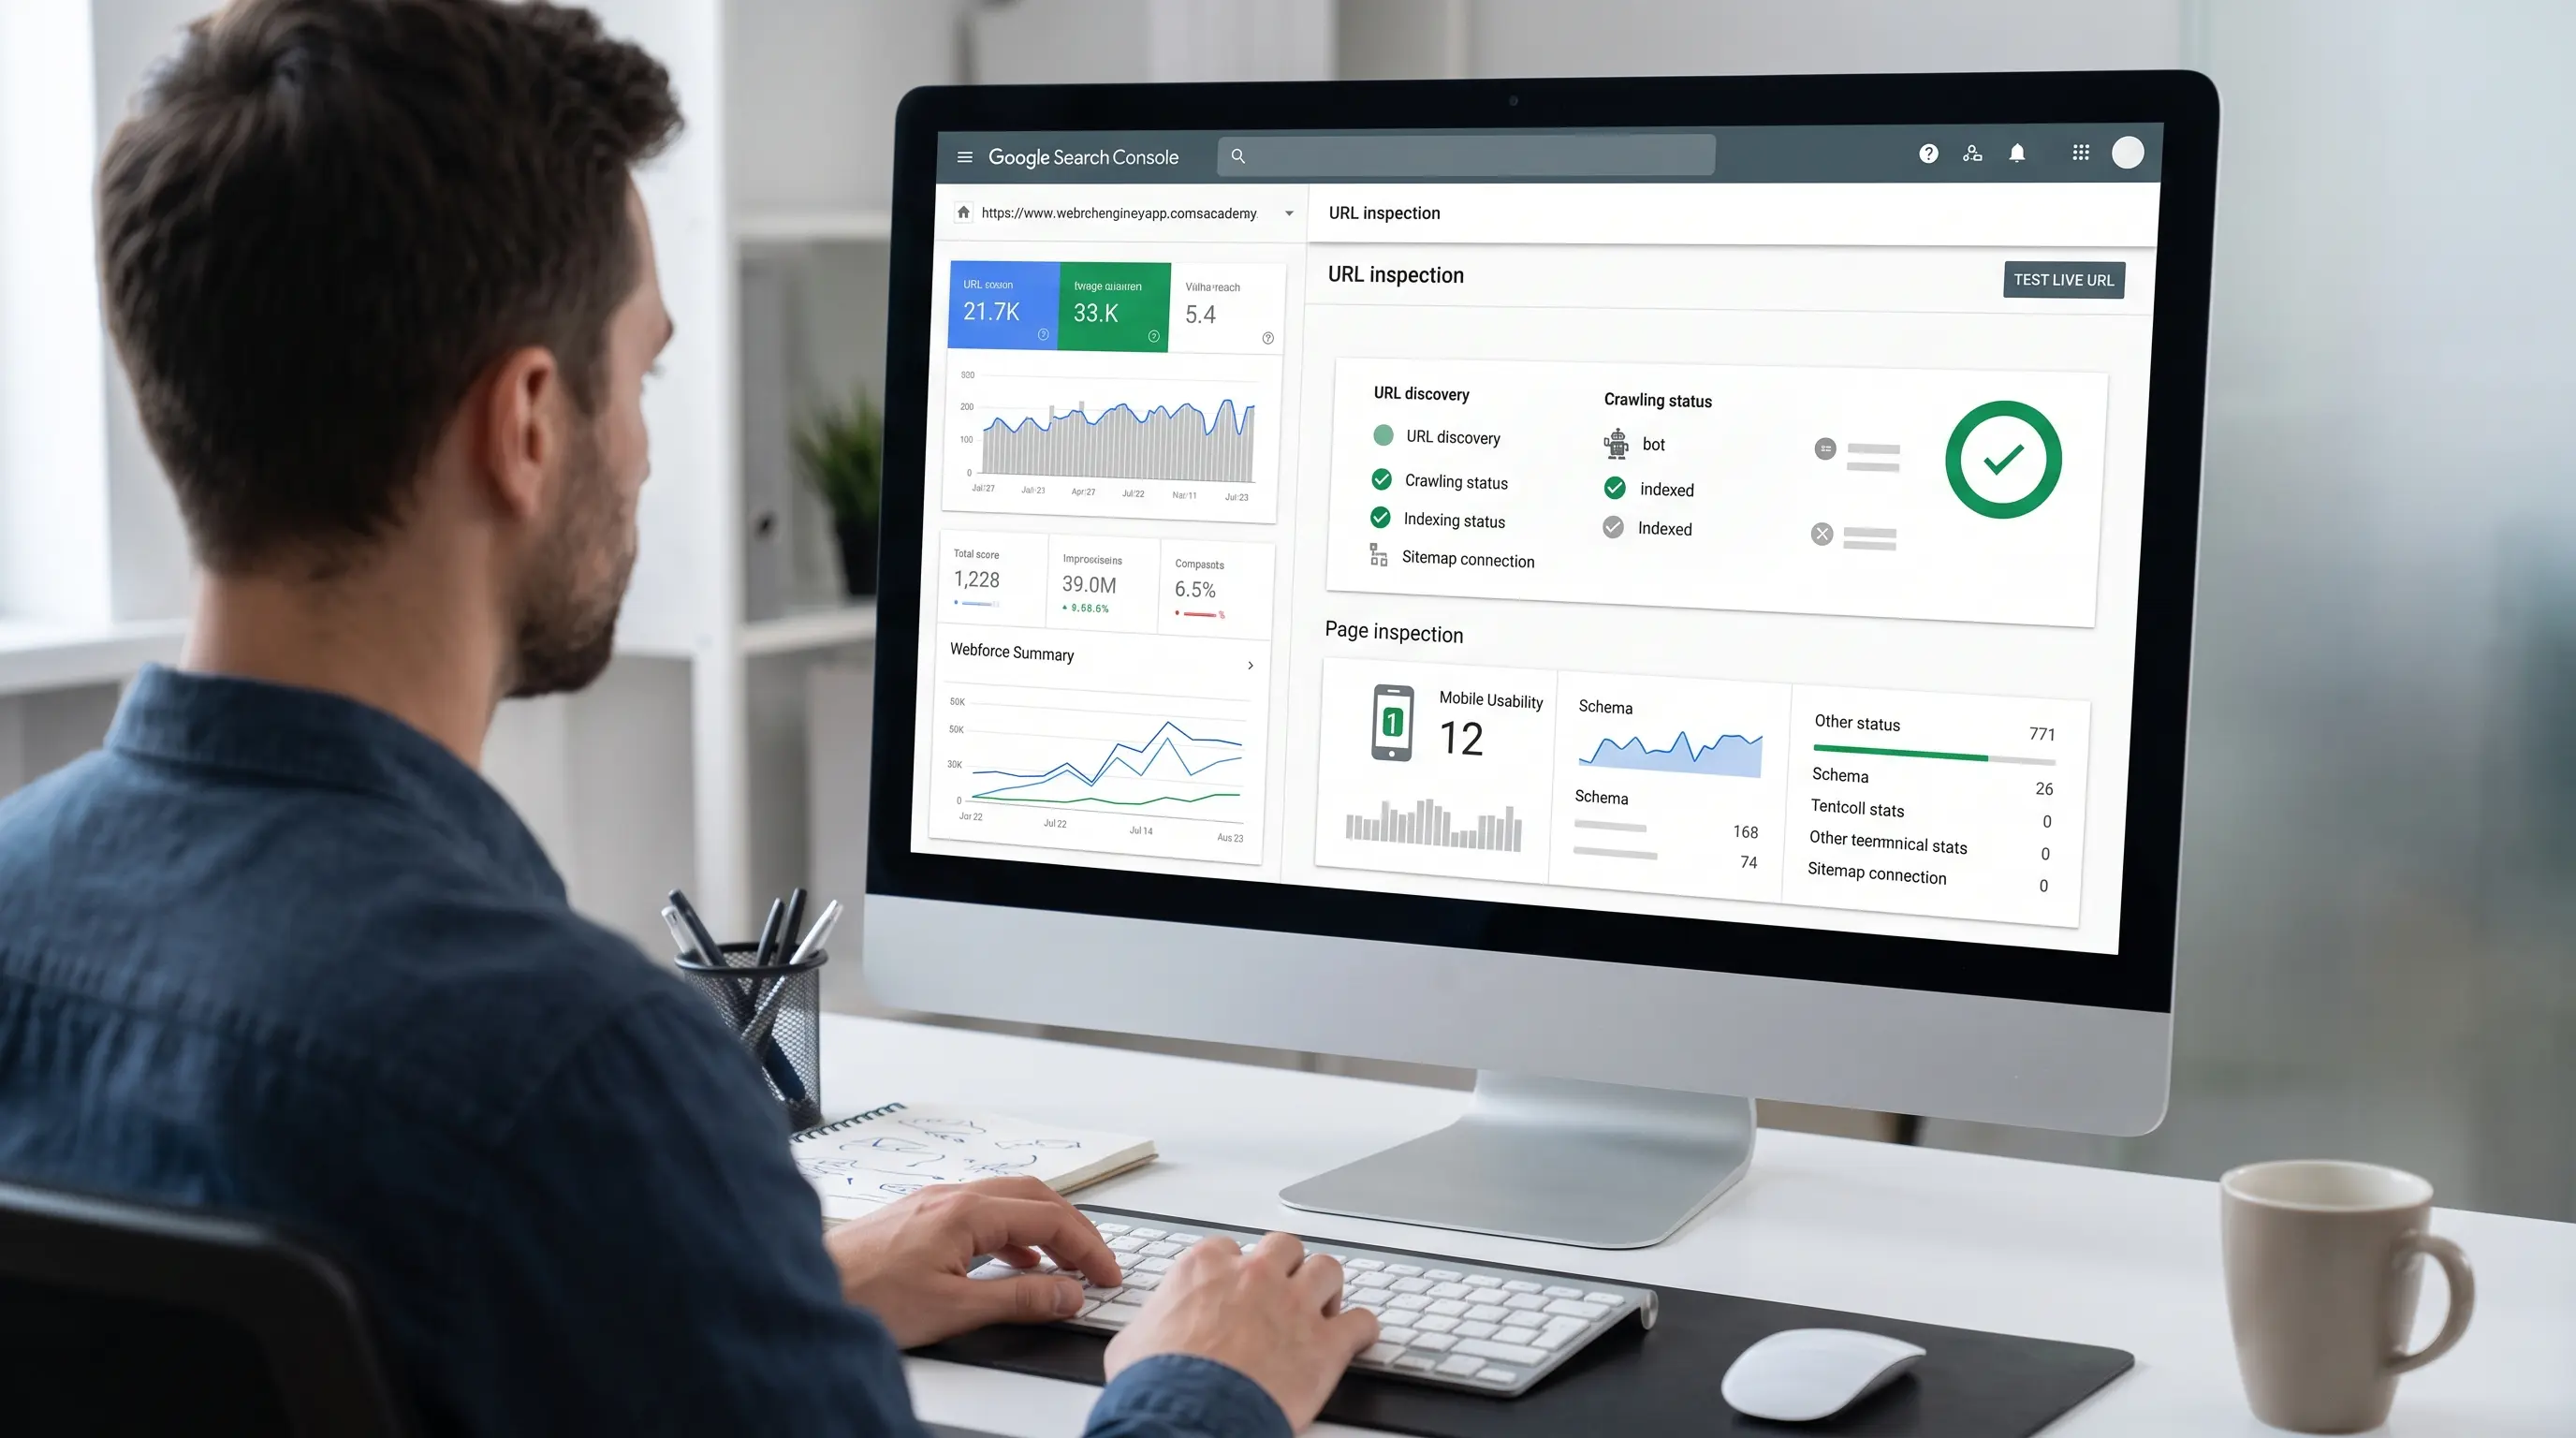
Untuk memeriksa artikel tertentu, gunakan URL Inspection di Google Search Console.
Masukkan URL lengkap artikel, misalnya:
https://example.com/artikel/contohGoogle Search Console dapat memberikan informasi mengenai apakah URL dikenal Google, kemampuan URL untuk di-crawl, status indexing, canonical, dan informasi crawling lainnya.
Jika URL belum dikenali, periksa kembali sitemap, internal link, robots.txt, dan akses halaman.
Apakah Harus Menggunakan Request Indexing?
Untuk artikel individual yang penting, Request Indexing bisa digunakan.
Caranya:
- Buka Google Search Console.
- Masukkan URL artikel ke URL Inspection.
- Jalankan pemeriksaan.
- Pastikan halaman dapat diakses.
- Gunakan opsi Request Indexing jika tersedia.
Tetapi jangan menganggap Request Indexing sebagai tombol "Paksa Google Index Sekarang".
Request Indexing tidak menjamin URL akan masuk Google Index.
Berapa Lama Google Akan Crawl Sitemap?
Tidak ada angka pasti yang berlaku untuk semua website.
Google akan mencoba mengambil sitemap setelah sitemap dikirim. Jika sitemap berhasil diproses, Google dapat mengambilnya kembali secara berkala.
Sementara itu, crawling URL yang ada di dalam sitemap merupakan proses tersendiri.
Karena itu, jangan membuat patokan bahwa setelah sitemap dikirim semua artikel harus langsung di-crawl dalam hitungan menit atau jam.
Checklist Jika Sitemap Sudah Dikirim Tapi Google Belum Crawl
Sebelum melakukan perubahan besar pada website, gunakan checklist berikut:
| Pemeriksaan | Yang Perlu Dicek |
|---|---|
| Sitemap | Apakah sitemap dapat dibuka? |
| URL Artikel | Apakah URL benar-benar masuk sitemap? |
| Search Console | Apakah status sitemap normal? |
| Robots.txt | Apakah artikel diblokir? |
| HTTP Status | Apakah halaman dapat diakses dengan normal? |
| Internal Link | Apakah ada link menuju artikel? |
| Canonical | Apakah canonical mengarah ke URL yang benar? |
| Noindex | Apakah halaman tidak sengaja menggunakan noindex? |
| Server | Apakah ada error 5xx atau timeout? |
| URL Inspection | Apa status URL menurut Google? |
Kalau semua pemeriksaan tersebut normal, langkah berikutnya biasanya adalah memberikan waktu kepada Google untuk melakukan crawling.
Kesalahan yang Sering Dilakukan
Mengirim Sitemap Berkali-kali
Kalau sitemap sudah berhasil diproses, mengirim ulang sitemap berkali-kali bukan solusi utama.
Menganggap Success Berarti Semua Artikel Sudah Di-Crawl
Status Success berarti sitemap berhasil diproses, bukan berarti semua URL sudah dikunjungi Googlebot.
Hanya Mengandalkan Sitemap
Sitemap penting, tetapi internal linking juga membantu Google menemukan halaman.
Meminta Indexing untuk Semua Artikel
Request Indexing lebih cocok digunakan untuk URL individual yang memang ingin diperiksa atau diminta untuk diproses.
Mengubah Robots.txt Sembarangan
Jangan menghapus atau mengubah aturan robots.txt tanpa memahami dampaknya.
Satu aturan Disallow yang terlalu luas bisa memblokir bagian website yang sebenarnya ingin ditampilkan di Google.
Menganggap Artikel Belum Terindex Berarti Sitemap Rusak
Belum tentu. Masalah indexing bisa berasal dari banyak hal, sedangkan sitemap hanya salah satu bagian dari keseluruhan proses.
Sitemap Bukan Jaminan Semua Artikel Masuk Google
Tujuan sitemap adalah membantu Google menemukan URL penting dari sebuah website.
Namun memasukkan URL ke sitemap bukan jaminan bahwa URL tersebut akan muncul di hasil pencarian.
Google memiliki proses tersendiri untuk crawling, pemrosesan, dan indexing.
Karena itu, jangan hanya mengejar target semua URL masuk Google.
Lebih baik fokus memastikan halaman penting:
- Dapat ditemukan.
- Dapat diakses.
- Tidak diblokir.
- Memiliki struktur internal link yang baik.
- Memiliki canonical yang sesuai.
- Tidak menggunakan noindex secara tidak sengaja.
- Memberikan konten yang bermanfaat bagi pengguna.
Bagaimana Strategi Sitemap yang Baik untuk Website?
Untuk website yang rutin menerbitkan artikel, sitemap sebaiknya dibuat otomatis.
Misalnya setiap kali artikel baru diterbitkan:
Artikel dibuat
     ↓
Artikel masuk database
     ↓
Sitemap diperbarui
     ↓
URL dapat ditemukan Google
     ↓
Google melakukan crawling
     ↓
Google memproses halaman
     ↓
URL berpotensi masuk index
Dengan sistem seperti ini, kita tidak perlu mengedit sitemap secara manual setiap kali membuat artikel.
Untuk website custom, pastikan generator sitemap mengambil data artikel yang memang ingin ditampilkan di Google.
Misalnya jangan memasukkan:
- Halaman admin.
- Halaman login.
- Halaman pencarian internal.
- URL hasil filter yang tidak diperlukan.
- Halaman duplikat.
- URL yang sudah dihapus.
- Halaman yang memang sengaja menggunakan
noindex.
Sitemap sebaiknya berisi URL yang memang dianggap penting bagi website.
Kesimpulan
Sitemap sudah dikirim tetapi Google belum crawl bukan berarti sitemap pasti bermasalah.
Google akan mencoba mengambil sitemap setelah sitemap dikirim. Jika sitemap berhasil diproses, URL yang dapat dibaca dapat masuk ke antrean crawling. Namun crawling URL tetap merupakan proses tersendiri.
Jika artikel belum di-crawl, periksa beberapa hal berikut:
- URL sudah masuk sitemap.
- Sitemap dapat diakses.
- Status sitemap di Search Console normal.
- Robots.txt tidak memblokir URL.
- Artikel dapat diakses dengan normal.
- Server tidak mengalami error.
- Artikel memiliki internal link.
- Canonical mengarah ke URL yang sesuai.
- Tidak ada
noindexyang tidak sengaja. - URL Inspection tidak menunjukkan masalah.
Dan yang paling penting, jangan langsung panik hanya karena artikel baru belum di-crawl dalam beberapa jam.
Crawling dan indexing membutuhkan proses. Google Search Console menyediakan berbagai alat untuk membantu kita melihat apa yang diketahui Google mengenai sebuah URL dan menemukan masalah yang mungkin menghambat proses tersebut.
Kalau semua konfigurasi sudah benar, tidak perlu terus-menerus mengirim sitemap atau meminta indexing berulang kali.
Pastikan struktur website sehat, sitemap selalu diperbarui, internal link berjalan dengan baik, lalu biarkan Google melakukan proses crawling secara alami.
FAQ
Kenapa sitemap sudah dikirim tetapi Google belum crawl?
Sitemap yang dikirim ke Google tidak menjamin URL langsung di-crawl. Google perlu memproses sitemap dan menentukan URL mana yang akan dirayapi. Proses tersebut dapat membutuhkan waktu, terutama pada website atau halaman baru.
Apa arti sitemap berstatus Success di Google Search Console?
Status Success berarti Google berhasil mengambil dan memproses sitemap tanpa error. Status tersebut bukan jaminan bahwa semua URL di dalam sitemap sudah atau pasti akan di-crawl dan di-index.
Apakah sitemap harus dikirim ulang setiap kali membuat artikel?
Tidak perlu mengirim ulang sitemap yang sama setiap kali artikel baru ditambahkan. Pastikan sitemap otomatis diperbarui sehingga URL baru masuk ke dalamnya.
Berapa lama Google melakukan crawling setelah sitemap dikirim?
Tidak ada waktu pasti. Beberapa halaman dapat membutuhkan waktu untuk ditemukan dan di-crawl Google. Website yang berbeda juga dapat memiliki pola crawling yang berbeda.
Apakah Request Indexing bisa memaksa Google meng-index artikel?
Tidak. Request Indexing tidak menjamin URL akan masuk Google Index. Fitur tersebut hanya digunakan untuk meminta Google mempertimbangkan URL tersebut untuk crawling.
Apakah robots.txt bisa membuat Google tidak crawl artikel?
Bisa. Aturan Disallow pada robots.txt dapat melarang crawler mengakses path tertentu.
Apakah semua URL di sitemap akan masuk Google?
Tidak. Google tidak menjamin seluruh URL dalam sitemap akan di-index. Sitemap berfungsi membantu Google menemukan URL, sedangkan keputusan indexing dilakukan melalui proses Google sendiri.
Apakah internal link penting untuk crawling Google?
Ya. Internal link membantu Google menemukan halaman melalui struktur website dan memahami hubungan antarhalaman.